DISPLAY SETTINGS 各種設定
Q1.自社のWebサイトで社内向けの動画検索インターフェースを提供するため、Azure Video Indexerサービスを利用しています。
視聴者が「動画に誰が映っているか」を手がかりに動画を検索できるようにする必要があります。
どのように構成すべきですか。
解答を見る
Azure AI Video Indexer(旧称 Azure Media Services Video Indexer)は動画内の人物の顔を検出し識別する機能を備えています。
特定の人物を検索可能にするには、アカウント内に人物モデルを作成し、そのモデルに顔を学習させる必要があります。
動画のアップロードや再インデックス化の際に人物モデルIDを指定すると、Video Indexerはそのカスタム人物モデルを用いて人物を識別します。
顔に名前を付けると人物情報がモデルへ追加され、以降や過去の動画でも同一人物として認識されます。
Bは仕組みが異なり、CやDは人物検索に無関係、Eの言語モデルも人物識別とは関係しません。
Video Indexer で人物モデルをカスタマイズする
Q2.Azure仮想マシンvm1上で動作するWebアプリapp1を作成します。
vm1はAzure仮想ネットワークvnet1に配置されています。
新たにAzure Cognitive Searchサービスservice1を作成する予定です。
パブリックインターネットを経由せずに、app1がservice1へ直接接続できるようにする必要があります。
解決策: service1をパブリックエンドポイントでデプロイし、IPファイアウォールルールを構成します。
この方法は目標を満たしますか。
解答を見る
IPファイアウォールルールはAzure AI Searchへのアクセス元IPを制限する機能にすぎません。
通信自体はパブリックエンドポイントを経由するため、トラフィックはインターネットを通ります。
したがって「パブリックインターネットを経由せずに接続する」という要件は満たせません。
要件を満たすにはAzure Private Linkでプライベートエンドポイントを作成し、仮想ネットワーク内のプライベートIP経由で接続する必要があります。
なおAzure Cognitive Searchは現在Azure AI Searchへ名称変更されています。
Azure AI Search でプライベート エンドポイントを作成する
Q3.Azure OpenAIのGPT-3.5モデルを利用するチャットボットを構築します。
チャットボットの応答品質を向上させる必要があります。
ソリューションは開発労力を最小限に抑える必要があります。
目標を達成する2つの方法はどれですか。
各回答はそれぞれ完全な解決策になります。
解答を見る
Azure OpenAIのチャットボットの応答品質を短期間で高めるには、モデルの再学習ではなくプロンプト設計の改善が有効です。
根拠となるコンテンツを提供する方法は外部データを参照させて正確性を高める手法で、一般にRAG(検索拡張生成)として実装されます。
これにより独自データに基づく回答が可能となり誤答を減らせます。
またサンプルのリクエストとレスポンスのペアを含めるFew-shotプロンプティングは、望ましい回答形式をモデルに示して品質を向上させます。
微調整やモデル再学習、カスタムLLM作成は工数が大きく最小化の要件に反します。
プロンプト エンジニアリングの手法
Q4.Azure AI LanguageリソースResource1を含むAzureサブスクリプションがあります。
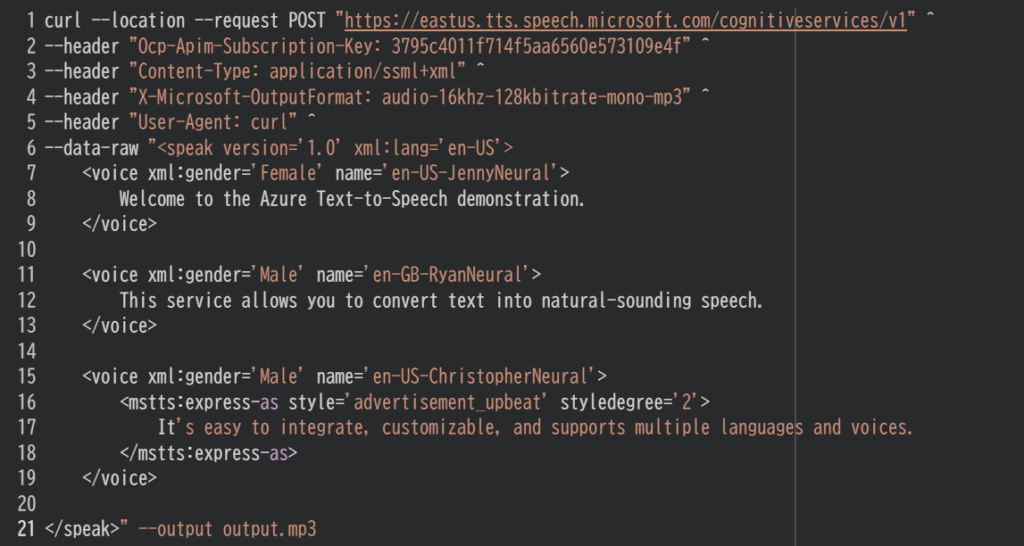
以下のcURLコマンドを実行し、Output.mp3ファイルを再生します。
コマンドが送信するSSMLでは、1つ目の音声 en-US-JennyNeural(女性)が「Welcome to the Azure Text-to-Speech demonstration.」を、2つ目の音声 en-GB-RyanNeural(男性)が「This service allows you to convert text into natural-sounding speech.」を、3つ目の音声 en-US-ChristopherNeural(男性、mstts:express-as style=advertisement_upbeat)が「It’s easy to integrate, customizable, and supports multiple languages and voices.」を読み上げます。
次の各記述について、正しければ「はい」、そうでなければ「いいえ」を選択してください。
| 問題文 | はい | いいえ | |
|---|---|---|---|
| 3つの文をそれぞれ異なる音声で聞くことができる | |||
| 3つの文をそれぞれ異なるアクセントで聞くことができる | |||
| 3つの文はすべてニュートラルなトーンで読み上げられる |
解答を見る
このSSMLには3つのvoice要素が含まれ、それぞれ異なる音声モデルが指定されています。
en-US-JennyNeural、en-GB-RyanNeural、en-US-ChristopherNeuralは別々の音声モデルのため、3つの異なる声で読み上げられます。
一方アクセントは米国英語が2つ、英国英語が1つで、3つすべてが異なるアクセントにはなりません。
3つ目の音声にはmstts:express-as style=advertisement_upbeatが指定され、広告向けの明るいスタイルになります。
そのためすべての文がニュートラルなトーンで読み上げられるわけではありません。
音声合成マークアップ言語 (SSML) の概要
Q5.Azure AI Speechサービスを利用するアプリを開発しています。
アプリがMicrosoft Entra IDトークンを用いてサービスへ認証できるようにする必要があります。
実行すべき2つのアクションはどれですか。
各回答はソリューションの一部となります。
解答を見る
Azure AI SpeechでMicrosoft Entra IDトークン認証を使う場合、リソースにカスタムサブドメインを構成する必要があります。
カスタムサブドメインによりサービス固有のエンドポイントURLが作成され、Entra IDトークンでの認証が可能になります。
さらにSpeechリソースにはプライベートエンドポイントの構成が必要です。
プライベートエンドポイントを使うと仮想ネットワークから安全に接続でき、Entra ID認証がサポートされます。
条件付きアクセスはユーザーアクセス制御、X.509証明書や仮想ネットワークサービスエンドポイントはこの認証の要件ではありません。
Azure AI Speech サービスのロールベース アクセス制御
Q6.多言語対応のチャットボットを構築しています。
ポジティブなメッセージとネガティブなメッセージで異なる応答を返す必要があります。
使用すべき2つのText Analytics APIはどれですか。
各回答は解決策の一部を示します。
解答を見る
チャットボットがポジティブとネガティブで応答を分けるには、まずユーザー文の感情を判定する必要があります。
Azure AI Languageの感情分析はテキストをポジティブ・ネガティブ・ニュートラルに分類し、信頼度スコアとともに結果を返します。
これにより感情に応じた応答処理を実装できます。
また多言語対応では入力言語が不明な場合があるため、言語検出APIでテキストの言語を識別する必要があります。
言語を特定してから感情分析を行うことで複数言語での感情判定が可能になります。
なおText Analytics APIは現在Azure AI Languageの一部として提供されています。
感情分析とオピニオン マイニングとは
Q7.Semantic Kernelを使ってアプリを構築しています。
アプリのプロンプトテンプレートには複雑なオブジェクトを含める必要があります。
ソリューションはサブプロパティを持つオブジェクトをサポートしなければなりません。
使用できる2つのプロンプトテンプレートはどれですか。
各回答はそれぞれ完全な解決策を示します。
解答を見る
Semantic Kernelで複雑なデータ構造をプロンプトに渡すには、テンプレートエンジンでオブジェクトのプロパティやコレクションを展開します。
LiquidとHandlebarsはいずれもテンプレート言語で、ネストしたオブジェクトのサブプロパティ参照や条件分岐、ループ処理をサポートします。
そのため複雑なオブジェクトの埋め込みに適しています。
一方JSONLはデータセット形式でありテンプレート言語ではありません。
YAMLは構成やデータ定義用のフォーマットでテンプレート処理機能を持ちません。
Semantic Kernel自体はフレームワークでありテンプレート言語ではないため不適切です。
Semantic Kernel のプロンプト テンプレート構文
Q8.Microsoft Bot Frameworkを使ってボットを構築しています。
音声によるリクエストへ応答できるようにボットを構成する必要があります。
ソリューションは開発労力を最小限に抑える必要があります。
何をすべきですか。
解答を見る
音声リクエストへ最小の開発労力で対応するには、ボットをAzureにデプロイし、Direct Line Speechチャネルに登録する方法が適切です。
Direct Line Speechは音声入力の認識と音声応答の合成を統合的に扱う音声対応チャネルで、追加の音声処理コードを実装せずに音声ボットを構成できます。
Bot Framework SDKでCortanaと統合する方法は、Cortanaスキルキットが提供終了となっており現在は利用できません。
Azure Functionsを介して音声処理を組む方法は独自実装が必要で工数が増えます。
Microsoft Teamsチャネルは主にテキスト対話向けで音声要件には適しません。
ボットを Direct Line Speech に接続する
Q9.Microsoft FoundryハブHub1、Azure OpenAIリソースresource1、およびユーザーUser1を含むAzureサブスクリプションがあります。
User1がHub1で新しいAzure Content Understanding in Foundry Toolsプロジェクトを作成できるようにする必要があります。
ソリューションは最小権限の原則に従う必要があります。
User1に割り当てるべきロールはどれですか。
解答を見る
Microsoft AI FoundryでAzure OpenAIを利用したプロジェクトを作成するには、ユーザーがAzure OpenAIリソースを使用する権限を持つ必要があります。
Cognitive Services OpenAIユーザーロールは、Azure OpenAIのモデルやエンドポイントを使うための最小限の権限を提供します。
このロールを割り当てれば、Azure AI FoundryのツールからAzure OpenAIリソースを使ってプロジェクトを作成できます。
一方Cognitive Services OpenAIコントリビューターやAzure AI管理者はリソース管理権限を含むため最小権限の原則に反します。
したがって必要最小限の権限で足りるCognitive Services OpenAIユーザーが適切です。
Azure OpenAI Service のロールベース アクセス制御
Q10.Face APIの呼び出しを開発しています。
この呼び出しでは、既存のemployeefacesというリストから類似する顔を検索する必要があります。
employeefacesリストには60,000枚の画像が含まれます。
HTTPリクエストの本文はどのように記述すべきですか。
解答を見る
Face APIで60,000件の顔画像を保持する場合、通常のfaceListIdではなくlargeFaceListIdを使用します。
Face Listは最大1,000顔までですが、Large Face Listは最大1,000,000顔までサポートするためです。
そのため問題①ではLargeFaceListIdが正解になります。
またmodeに指定する値はmatchFaceが適切です。
matchFaceは入力した顔に最も類似する顔を検索するモードで、1対1の類似検索に用います。
一方matchPersonは同一人物候補を広く検索する用途のため問題②には適しません。
似た顔の検索